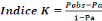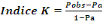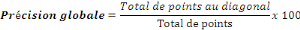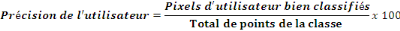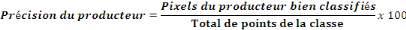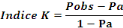
|
Caracterisation de la vegetation des tourbieres de Wasalaka dans le bassin de la riviere Itimbiri dans le contexte du changement environnementalpar Jean Pierre Apandani Université de Lisala - Maitrise 2024 |
NDWI : Calcul De L'indice D'eau Par Différence NormaliséeL'équation pour le calcul de NDWI : NDWI = (Green - NIR)/(Green + NIR) · Pour les données Landsat 7 : NDWI = (Band 2 - Band 4)/(Band 2 + Band 4) · Pour les données Landsat 8 : NDWI = (Band 3 - Band 5)/(Band 3 + Band 5) · Pour les données Sentinelle 2 : NDWI= (Band 3 - Band 8)/(Band 3 + Band 8) Le vert visible maximise la capacité de réflexion de la surface de l'eau. Le proche infrarouge maximise la capacité de réflexion élevée de la végétation terrestre et des éléments du sol et minimise la capacité de réflexion faible des bassins d'eau. Les résultats de la résolution de l'équation pour l'indice NDWI sont les bassins d'eau et les valeurs négatives (ou nulles) pour le sol et la végétation terrestre. NDWI : Interprétation Des ValeursLes valeurs de l'indice NDWI pour les bassins d'eau sont supérieures à 0,5. L'indice NDWI pour la végétation prend les valeurs beaucoup plus faibles, ce qui permet de distinguer plus facilement la végétation et les bassins d'eau. L'indice NDWI pour les éléments bâtis prend les valeurs positives comprises entre 0 et 0,2. Les valeurs de l'indice NDWI correspondent aux plages suivantes : · 0,2 - 1 - Surface de l'eau, · 0.0 - 0,2 - Inondation, haute humidité, · -0,3 - 0.0 - Sécheresse modérée, surfaces non aqueuses, · -1 - -0.3 - Sécheresse, surfaces non aqueuses L'indice d'eau par différence normalisée (NDWI) est utilisé pour détecter les bassins d'eaux ouvertes sur l'image satellitaire : le corps hydrique «se d NDWI : Utilisation De L'indiceChaque fois qu'il est nécessaire de détecter un bassin d'eau, de préciser son contour sur la carte et de surveiller les changements de sa clarté, l'indice NDWI est appliqué. Au-delà du spectre visible vers l'infrarouge, l'eau ne réfléchit pas la lumière. Grâce à cette propriété de l'eau, NDWI utilise avec succès pour délimiter les bassins d'eau sur les cartes de terrain et surveiller la turbidité de l'eau. NDWI : Visualisation de L'indiceLes données extraites de l'image satellitaire à l'aide de l'indice NDWI sont visualisées sous forme des cartes : on utilise de diverses palettes et des graphiques pour montrer l'évolution temporelle des valeurs de l'indice. Les valeurs plus élevées proches de +1 sont généralement affichées en bleu et correspondent soit à l'haute teneur en eau, soit à la surface d'eau, tandis que les valeurs plus basses, jusqu'à -1, sont les signes de la sécheresse, à moins que la zone de l'intérêt soit une surface non aqueuse. 3.2.4. Indice de végétation SAVI SAVI est l'acronyme anglais de Soil Adjusted Vegetation Index. Tout comme le NDVI, le SAVI donne une indication sur la présence ou l'absence de végétation pour tout pixel. Une forte valeur de SAVI traduit un pixel couvert de végétation en bonne santé et une faible valeur traduite plutôt un sol sans végétation. Le SAVI introduit un facteur correctif qui prend en compte la présence de sol nu au sein de la végétation. Par exemple, dans le cas d'une forêt éparse ou d'une savane sèche, où les arbres se trouvent séparés les uns des autres par du sol nu, le SAVI peut produire des résultats rendant mieux compte du couvert végétal que le NDVI. Le SAVI se calcule comme suit : ????????=(1+??)(??????-??)/(??????+??+??) où PIR correspond à la bande spectrale du Proche infrarouge, R correspond à la bande spectrale du Rouge et L correspond au facteur correctif de sol nu. Le facteur L peut varier entre 0 et 1 selon les configurations mais il est admis qu'une valeur de 0.5 donne de bons résultats en règle générale. La figure présente le SAVI calculé sur les Bouches-du-Rhône le 13 juin 2019 à partir d'une image Landsat 8(image OLI).
Fig.14. SAVI des Bouches-du-Rhône pour le 13 juin 2019. 3.2.5. Indice d'Urbanisation(bâti) NDBI L'indice d'urbanisation par différence normalisé a consisté à mesurer la proportion de zones construites dans une zone géographique. Cette mesure est utile pour suivre les changements dans l'urbanisation et la croissance des villes, ainsi que pour identifier les zones à risque de catastrophes naturelles telles que les inondations et les glissements de terrain. Il utilise les canaux NIR et SWIR pour mettre en évidence les agglomérations. NDBI= (SWIR-NIR) / (SWIR+NIR) 3.2.6. Indice Standardisé de Précipitations (Standardized Precipitation Index, SPI) L'indice Standardisé de Précipitations détermine le degré de la sècheresse avec différentes classes (Bergaoui et Alouini, 2001 ; Ardoin-Bardin et al., 2003 ; Ardoin-Bardin, 2004 ; Ali et Lebel, 2009 ; Lebel et Ali, 2009). Il a été créé par Mckee et al. (1993) et a été employé par de nombreux auteurs sur diverses régions du globe (WU et al., 2001 ; Giddings et al., 2005 ; Sönmez et al., 2005 ; Bodian, 2014). Il est calculé suivant cette formule : ?????? = ???? - ???????? Xi représente le cumul de la pluie pour une année i ; Xm représente la moyenne des pluies annuelles observées pour une série donnée. Si représente l'écart type des pluies annuelles observées pour une série donnée. Les valeurs annuelles négatives indiquent une sécheresse par rapport à la période de référence choisie et les positives une situation humide. Lutonadio 2020. Le Tableau 1 présente les différentes classes de l'indice standardisé de précipitations.
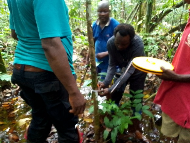
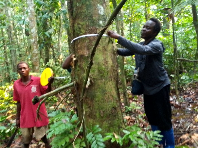
3.3. Inventaire de la flore L'inventaire floristique est réalisé (Identification des familles, genres et espèces et/ou nom local) pour toutes les espèces végétales (arbres, arbustes, et herbes) présentes dans une parcelle de (50 x 50) m2 installées au point de prélèvement de l'échantillon de tourbe des quatre (4) placettes. L'analyse des données nous a permis de ressortir un parallélisme spatial avec les taxons. Figure 110:mesure de dhp et inventaire des essences floristiques dans la station d'étude
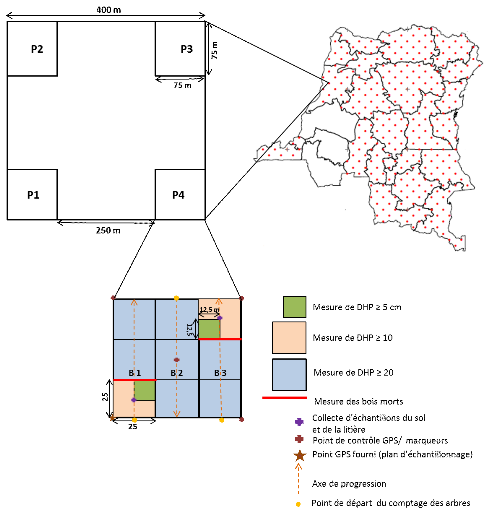
(source: photo numérique JP Apandani, 2024) Délimitation des zones d'inventaires Les zones d'inventaires ont été préalablement matérialisées par un tracé (Figure 2). Le point de départ de ce tracé peut être un des angles de la parcelle choisi de manière aléatoire sur le terrain. A l'aide du décamètre, nous avons mesuré la surface totale à inventorier et nous l'avons matérialisé à l'aide de petits piquets en plastique de couleur vive (Figure 3). Pour une végétation de type prairial, c'est-à-dire à des hauteurs comprises entre 20 et 60 cm (avec un seuil optimal compris entre 20 et 40 cm), nous mesurions dans un premier temps, avec l'aide du décamètre, la surface totale à inventorier. Puis dans un deuxième temps, nous la matérialisions cette surface, à l'aide de petits piquets en plastique de couleur vive (Figure 3). 0. Figure 2. Délimitation de la zone d'inventaire 1000 m2. 1. Méthodologie de la recherche(inventaire) Les analyses de l'inventaire floristique sont basées sur le plan d'échantillonnage, la description d'une unité d'échantillonnage (UE) au format IFN, la définition des procédures de travail de collecte des données botaniques sur terrain, l'analyse des données, la préparation des fiches de terrain et les cartes d'accès aux unités d'échantillonnage, et l'inventaire botanique proprement dit. Les données sont relevées sur le terrain à travers des observations, des mesures et des entrevues réalisées à différents niveaux : dans les limites des UE et dans des sous-unités plus petites, les parcelles, les sous-parcelles, les Sections d'Occupation du Sol (SOS) et les Classes d'Occupation du Sol (COS) délimitées à l'intérieur des UE. Graphique 39:Schéma d'une unité d'échantillonnage, d'une parcelle et d'une sous-parcelle au format de l'IFN
source : enquête terrain 2024 Ainsi, dans le cadre de cette étude, une UE est un carré de 50 m x 50 m. Lors de l'investigation, les coordonnées de l'angle sud-ouest des UE vont correspondrent à celles des points de référence pour l'établissement des UE. Chaque UE va contenir un groupe de quatre parcelles de terrain. Quant aux parcelles, elles seront des carrés mesurant 25 m x 25m délimités à l'intérieur de l'UE de 50 m x 50 m. Elles partent de chaque angle de l'UE et sont numérotées de 1 à 4 dans le sens des aiguilles d'une montre. Pour apprécier la santé de l'écosystème, deux lignes de transect de bois mort (TBM) sont installées à la fin de chaque sous-parcelle moyenne en vue de collecter les données dans les fiches spécifiques. Des parcelles dans l'UE auront chacune une localisation et une orientation bien indiquée dans le Tableau 1 ci-dessous. Tableau2. Caractéristiques des UE
Note : Toutes les distances indiquées sont des distances horizontales. Les données à collecter dans les UE, parcelles, sous-parcelles, points de mesure, sections d'occupation du sol (SOS), classes d'occupation du sol (COS) et personnes enquêtées seront relevées par l'équipe de terrain. Les principales sources d'information à considérer pour l'inventaire sont : ï Les mesures et observations de terrain ; ï Les entrevues avec des informateurs clés notamment sur l'identification des produits forestiers non ligneux (ou autre que le bois d'oeuvre) par les populations locales et peuples autochtones. 3.4. Protocole de validation de la classification de l'occupation du sol Il existe plusieurs méthodes statistiques de validation de la classification (Carte). Pour cette étude, c'est l'indice Kappa qui a été utilisée. Le bassin versant a été extrait d'une image SRTM à l'aide de l'outil wathershed du logiciel ArcGis qui permet d'extraire un sous bassin versant dans un ensemble plus vaste. Le shapefile du bassin a servi d'extraire notre zone d'étude à partir des images composites de l'année 2001, 2013 et 2020 à l'aide de l'outil Extract by Mask d'ArcGIS. La validation de la classification de l'occupation du sol a suivi plusieurs étapes suivant un protocole bien précis. Les différentes classes d'occupation du sol ont été extraites de la couche classifiée afin d'obtenir des couches des classes séparées. Pour la matrice de confusion, les points pour chaque classe ont été générés aléatoirement en fonction de son pourcentage. Indice de Kappa Les points des échantillons ont été prélevé sur terrain dans sur chaque classe d'occupation du sol grâce à l'outil GPS. Par ailleurs, la validation des classes d'occupation et celle de la classe zone de tourbières ont été faite en vérifiant les nombre de pixels se superposant avec les points collectés sur terrain. Cette comparaison avait pour but d'évaluer la conformité entre la classification des images et la vérité de terrain. Après cette vérification, le nombre de points correctement classifiés et ceux mal classifiés pour chaque classe ont été insérés dans une table de contingence (matrice de confusion) pour évaluer les résultats de l'interprétation par rapport aux informations de terrain reconnues comme étant « la vérité ». Elle est une méthode conventionnelle d'évaluation de la précision thématique d'une carte. À partir de la matrice de confusion réalisée, différents indicateurs de précision ont été calculés en l'occurrence : Avec K : Indice de Kapa, Pobs : Proportion observée (somme des effectifs diagonaux divisée par le total général des points), Pa : Proportion aléatoire (somme des produits des effectifs marginaux divisée par le carré du total général des points. Précision globale : La précision globale indique le rapport entre les prévisions positives de pixels bien classés et le nombre total de prévisions positives. Son expression mathématique se présente comme ci-dessous :
Précision d'utilisateur : Elle
représente le pourcentage de pixels d'une occupation du sol qui ont
été bien classifiés par l'utilisateur (Bwangoy, 2021). Sa
formule est : Précision de producteur : Elle
correspond au pourcentage de pixels d'une occupation du sol bien
classifiés par le producteur (Bwangoy,2021). Sa formule est la suivante
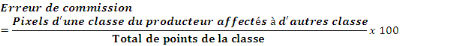
: Erreur de Commission : Elle évalue le niveau de désaccord des classes du producteur par rapport à celles de l'utilisateur. Elle est calculée par la formule suivante :
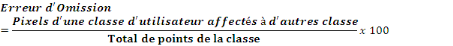
Erreur de commission : Elle mesure le niveau de désaccord des classes de l'utilisateur par rapport à celles du producteur.
Indice de Kappa : Permet d'évaluer le
degré d'accord entre le résultat obtenu par classification et la
réalité de terrain et de la classification. L'équation
ci-dessous exprime ce degré d'accord. Pobs : Proportion observée (somme des effectifs diagonaux divisée par le total général des points), Pa : Proportion aléatoire (somme des produits des effectifs marginaux divisée par le carré du total général des points. Cette recherche a recouru à deux sources des données principales à savoir les sources des données primaires et secondaires. Les données primaires sont des données collectées grâce à l'inventaire floristique réalisé sur la zone à tourbières de Wasalaka dans le bassin de la rivière d'Itimbiri dont le comptage des espèces, types et les diamètres à hauteurs de poitrine (DHP). S'agissant des sources des données secondaires, elles sont issues des observations spatiales. Le Tableau ci-dessous présente les données utilisées et leurs sources. La Figure présente la Schéma Synthèse de la méthodologie utilisée pour cette étude. Tableau 3 :Données utilisées
Figure 15 : Schéma Synthèse de la méthodologie utilisée pour cette étude DONNEES Images landsat08OLI-TIR,1-5 ;5-7 et 8-9 Données collectées dans les tourbières ANALYSES Classification LULC et Analyse de dynamique hydrologique Dynamique d'Occupation du Sol Analyse spatiale des Indices forestières (NDVI, NDWI et SAVI) Distribution spatiale des espèces RESULTATS Validation des Données Zones humides de la végétation type de flore Caractérisation des tourbières CHAPITRE QUATRIEME : RESULTATS ET DISCUSSION |
| ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||